Agentisk kodning, del 3: Måste vi förstå det vi litar på?
Måste vi förstå koden för att kunna lita på den? I den här artikeln utmanar vår kollega Peter sin egen tidigare slutsats och utforskar ”evolutionär kodning”, där agenter bygger, granskar och väljer ut kod utan att någon människa läser den. Utvecklarens ansvar flyttas då från koden till målen och miljön som väljer ut den.
Ni har säkert sett i era LinkedIn-flöden att agenterna nu är ”INSANE!”, och att flera skeptiker som tidigare hånade verktygens tafatta försök att förstå mer komplexa kodbaser och oförmåga till långa resonemang en efter en fått ändra sig, inte minst med lanseringen av modeller som Claude Opus 5.5, Fable 5.2 och GPT-6.
Vissa team säger sig numera skeppa kod till produktion utan mänsklig granskning. I stället har de ett råd av en mängd agentiska reviewers och critics som granskar allt från spec till kod. Ja, ni hörde rätt. Agenterna sköter både utveckling, granskning, testning och lansering till produktion. Kanske har du till och med hört om något bolag som faktiskt mätt att kvaliteten blir ännu bättre i de helt agentiska flödena.
Tidigare har jag argumenterat för att rollen som utvecklare skiftar från att skriva kod till att förstå verksamhetens problem och verifiera koden.
Den här gången vill jag utmana min egen slutsats en aning. Tänk om kodgranskning inte är något vi ska effektivisera, utan något vi redan har börjat lämna bakom oss?
Ett koncept som kan motivera denna övergång är idén om ”evolutionär kodning”. I stället för att en agent skriver en kodrad som en människa läser och godkänner, får många varianter tävla mot varandra. De som klarar kraven bäst går vidare, förändras och tävlar igen.
Ingen behöver förstå hur vinnaren ser ut under huven, bara att den fungerar. Det låter kanske för bra för att vara sant, och det rubbar ett antagande som de flesta av oss aldrig ifrågasatt, nämligen att vi måste förstå ett system för att kunna lita på det.
Ingen har kodgranskat människan
Om vi tar något så nära oss som oss själva, människan, så är vi ju ett av de mest komplexa system vi känner till. Ingen har designat oss, och ingen har läst igenom vårt DNA och godkänt det. (Ok, vissa kanske ifrågasätter evolutionen, men det får bli en annan text.)
Vår arvsmassa är som bekant full av upprepningar, mutationer, rester av evolutionär historia och sekvenser vi inte vet vad de gör. Med vissa utvecklares ögon är detta ”skräp-DNA” teknisk skuld i en skala vi aldrig skulle acceptera i en kodbas. Ändå fungerar vi, och förvånansvärt bra.
Evolutionen väljer det som överlever i en viss miljö, oavsett hur det är byggt. Om vår ”kod” skulle passera en code review har aldrig spelat någon roll.
För mjukvara skulle det betyda att vi slutar granska hur systemet är byggt och i stället prövar vad det klarar, och hur länge det håller.
Det händer redan
Dan Shapiro beskrev i januari 2026 fem nivåer av AI-assisterad utveckling och kallade den högsta för the dark factory, efter de släckta fabrikerna där robotarna arbetar i mörker eftersom ingen människa behöver se.
StrongDM, som bygger säkerhetsprogramvara, driver en sådan fabrik sedan sommaren 2025. Teamets två grundregler är att kod inte får skrivas av människor och inte får granskas av människor. I stället prövas allt mot scenarier som agenterna inte får se, i en simulerad värld med kopior av tjänster som Okta, Jira och Slack. Deras egen sammanfattning är att validering ersätter kodgranskning.
På OpenAI byggde ett internt team en produkt med ungefär en miljon rader kod på fem månader, utan en enda handskriven rad. Människor får granska ändringarna men behöver inte, och nästan all granskning sker mellan agenter. När takten ökade blev människornas tid och uppmärksamhet flaskhalsen.
Hos Anthropic självt slogs omkring 2 500 kodändringar ihop per dag i maj 2026. I september var siffran över 30 000 per dag. Teamet som byggde bolagets nya versionshanteringssystem granskar fortfarande varje ändring, men de tittar numera på avsikten med den snarare än att läsa varje rad.
Google kör det som ligger närmast evolutionär kodning i bokstavlig mening. Med AlphaEvolve får varianter av kod tävla mot automatiska bedömare. En schemaläggningsalgoritm som vuxit fram på det sättet körs i Googles datacenter och frigör enligt Google i snitt 0,7 procent av bolagets globala beräkningskapacitet.
Det är små team och ofta avgränsade problem, och berättelserna kommer mest från bolagen själva. Är det hype eller fungerar det på riktigt? Frågan är om den stora massan vågar, eller ens vill, ta steget dit.
Hindret till 10x är vårt behov av förståelse
Vad är argumentet för att ”släppa taget” om förståelsen av systemet? Tänk dig en utvecklare som styr tio kodagenter. Om den mänskliga utvecklaren måste läsa, förstå och godkänna varje rad de skriver spelar det ingen roll hur snabba agenterna är. Hon blir flaskhalsen och vi stannar kanske på 3x, om ens det.
Där står många i dag. Agenterna skriver fort, men varje förändring måste förbi samma knappa resurs, en människas uppmärksamhet. Vi har snabbat upp produktionen av kod, men inte förståelsen av den.
Med evolutionär kodning flyttas uppmärksamheten. Människan sätter målen och tittar på resultaten. Då behöver vår förståelse inte växa i takt med mängden kod, och fler agenter kräver inte fler granskare.
Men för oss som jobbar i utvecklarbranschen uppstår frågan: om förståelse inte längre är det som skapar förtroende, vad gör det då? Då kan ju vem som helst skriva en applikation. Varför ska vi ens ha utvecklare och konsulter?
Var behövs utvecklaren och konsulten i den evolutionära kodningen?
Om vi går tillbaka till liknelsen med människans DNA, så är vår arkitektur och implementation formade av vilka som överlevde och förde generna vidare under de förhållanden som rådde. Pålitlighet och underhåll på individnivå var inte prioriterade. Rent krasst spelade det mindre roll för hela populationen om några människor strök med p.g.a. en felaktig anpassning till miljön, så länge vi kunde skapa livskraftig avkomma.
Cancer, ärftliga sjukdomar och åldrande visar att evolutionär framgång och tillförlitlighet är två olika saker. Människan blev framgångsrik som population, men individen drabbas inte sällan av genetiskt orsakade motgångar. Det gäller mjukvara också. Låter vi Claude eller ChatGPT ta fram en bankapplikation och belönar lyckade transaktioner och snabbhet, kan vi få något som briljerar i varje test men har ett katastrofalt säkerhetshål. Och eftersom ingen förstår koden kanske ingen heller hittar hålet. Måldefinitionen, att förstå och formulera komplexa syften och mål som exempelvis utgår från kundernas behov, är viktig. Men vi behöver också urvalsmiljön som säkerställer tillförlitligheten.
HumanLayer körde sin egen produkt helt utan mänsklig granskning från sommaren 2025. Till slut gick sajten ner, agenten kunde inte laga felet, och svaret låg begravt i kod som ingen läst på tre månader. De slog på den manuella kodgranskningen igen. Deras lärdom var att det går snabbt att se om koden fungerar, men att dålig arkitektur börjar kosta först efter månader eller år. Inget i deras tester mätte det.
Kanske hade HumanLayer en bra måldefinition men behövde bättre urvalsmiljöer, med tester som speglar verkligheten, agenter vars enda uppgift är att försöka knäcka systemet, krav på säkerhet, integritet och prestanda, och oberoende bedömare som inte varit med och byggt det.
Ett mer ambitiöst upplägg, som liknar evolutionen, vore flera populationer som utvecklas samtidigt. Byggare tävlar om att skapa bäst system, angripare tävlar om att hitta svagheter och bedömare blir allt bättre på att skilja verklig kvalitet från ytlig. Angriparna och bedömarna blir då mjukvarans immunförsvar, på samma sätt som vårt eget anpassar sig efter nya sjukdomar.
Problemet är att även bedömarna kan börja dra åt fel håll, eller luras. Någonstans behövs fasta kriterier, formulerade av människor, att mäta allt mot.
Från kod till resultat
Om människan sätter målen och bygger urvalsmiljön flyttas också vårt ansvar som utvecklare, från koden till resultatet.
Men om stickproven till slut visar att det våra agentiska kodare och granskare tar fram håller bättre än det vi själva hade gjort, inte minst i faktiskt utfall och funktion, är det då inte dags även för skeptikern att tänka om?
Och när även granskningen och produktionssättningen är automatiserade börjar vi på riktigt närma oss den där berömda ”10x engineer”.
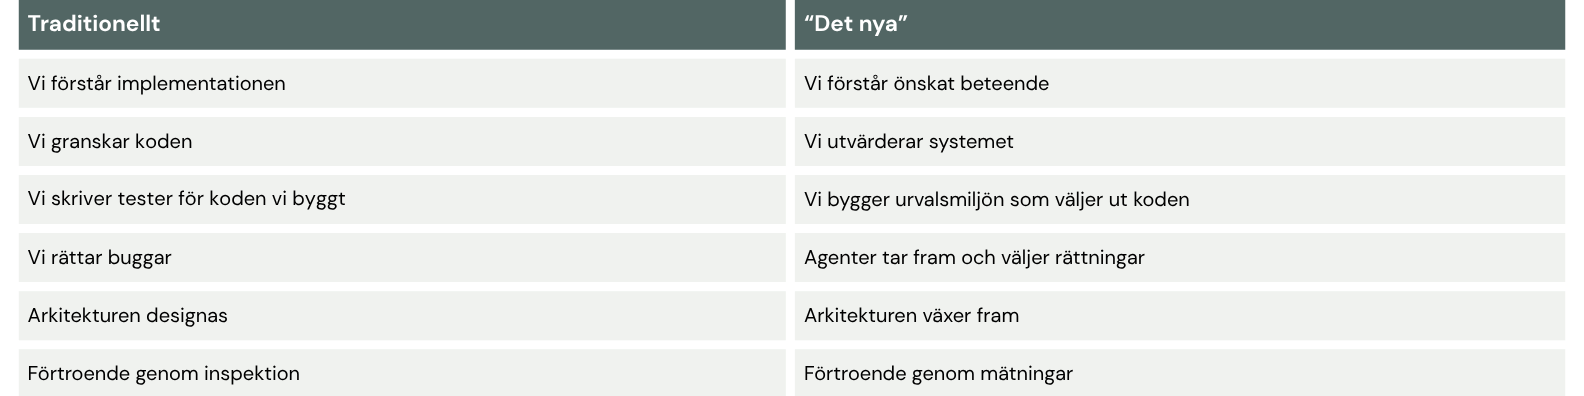
Nedan är en sammanställning över hur jag ser på traditionell utveckling jämfört med en utveckling som redan sker på vissa håll (dark factory, evolutionär kodning):
Vad skulle krävas för att övertyga dig?
En demo där en agent gör en sorteringsalgoritm 30 procent snabbare kanske övertygar någon. Det är imponerande, men säger lite om vardagen i våra kunders komplexa miljöer.
Vissa menar att det kommer en backlash om några månader eller ett år. Säkerhetshål, teknisk skuld, spagettikod och arkitektur som mest liknar något av Gaudí.
Så det som saknas är det långa, oberoende perspektivet. Någon behöver följa applikationer som lever i år med ändrade krav och låta en utomstående mäta fel, säkerhet, tillförlitlighet och total kostnad, jämfört med både traditionell utveckling och vanlig agentisk kodning.
Men om den evolutionära kodningen vinner gång på gång blir argumentet för obligatorisk kodgranskning betydligt svagare. Ansvar, lagkrav och riskhantering försvinner inte. Inget av det kräver att någon läser varje rad.
Sammanfattningsvis
Det finns ingen naturlag som säger att mjukvara måste vara begriplig för människor. Vi accepterar det redan i neurala nätverk, där ingen kan förklara varje beräkning bakom ett svar men alla kan mäta hur bra svaren är.
Det svåra blir då att bygga en miljö som skiljer bra mjukvara från dålig, utan att någon behöver läsa den.
Jag hade nog rätt i att utvecklarens och konsultens roll går mer mot att verifiera än att koda. Jag trodde bara att det var koden vi skulle verifiera. Nu är jag mer inne på att det är målen och miljön som väljer ut koden.
Vad tycker du? Är du fortfarande en skeptiker eller har du redan anammat arbetssättet? Eller kanske har du som HumanLayer provat, men tvingats backa?
Kontakt
